PDF公式识别工具先区分文本和扫描件
更新于
使用PDF公式识别工具之前,先检查手里的文件是哪种材料:正文可以选择的文档、整页扫描图,或两种页面混在一起的讲义。这个判断决定先尝试提取文字还是准备图像,也能避免把“复制出一些字符”误当成已经得到可编辑公式。
可选择文字不等于公式结构完整
在现有阅读器里试选一小段正文,再试选公式附近的内容,观察选区和复制结果。若正文能正常提取而公式变成零散字符,应单独判断公式对象,不能用正文结果推断整页都适合文本处理。有些扫描件还叠加了识别文本层,能选择文字也不说明它与底图完全一致。
对提取出的式子,检查字符顺序、上下标与分数关系。原页上上下排布的分式,复制后可能只剩一串主行字符;这时文字并没有保留完整的数学含义。若结构无法确认,可以转为对公式区域做图像识别,再人工核对。不要只因少了几个符号,就在没有原图依据时凭印象补齐。
扫描页从页码与裁切范围准备
先记录文件名称、阅读器中的页面序号,以及纸面上印出的页码。封面和目录会让两种页码不同,后续返查时只记一个数字容易找错。找到公式后,适当放大到能看清小下标的程度,判断原始图像是否有倾斜、阴影或严重模糊;显示放大不能创造原图没有的细节。
裁切要包含整条公式的上下边界、求和上下限和右端条件,同时避开不相关的段落。若公式分成两行,不要只取第一行;编号需要用于追踪时可以记入清单,不必让它混进待识别的数学区域。双栏论文应按实际阅读顺序处理,避免一次框入相邻栏的半条式子,给后续结构判断增加干扰。
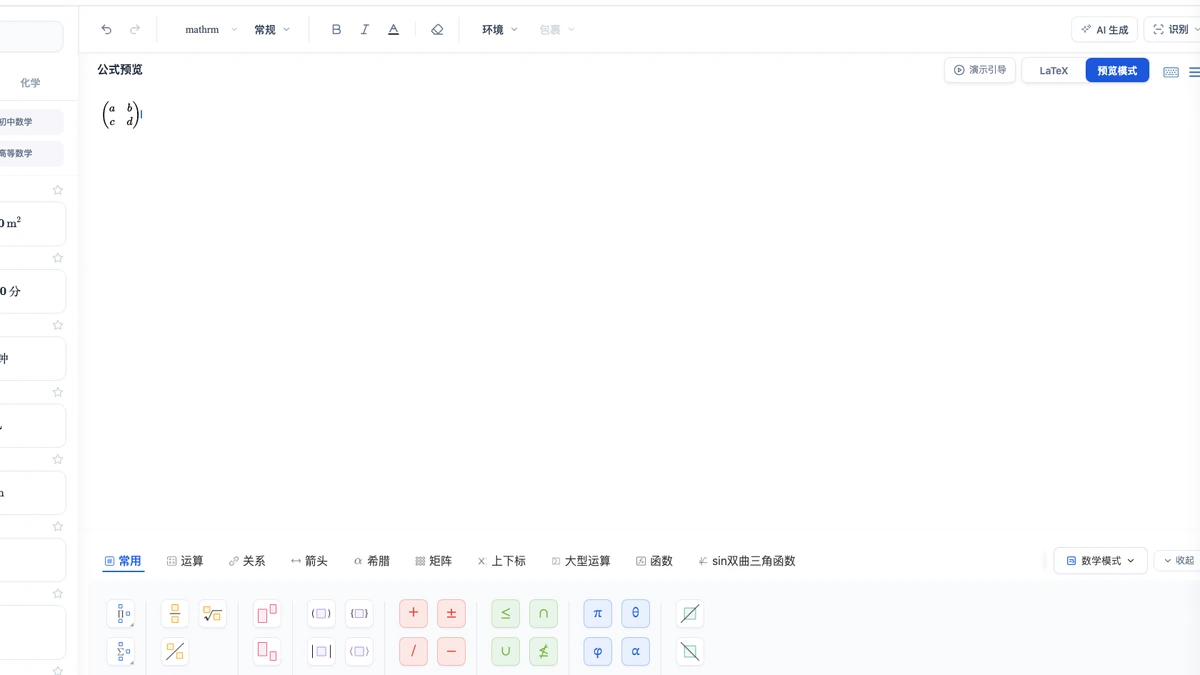
先用代表页验证识别与回改
挑一页常规内容,再挑一页带复杂分式或小字号的材料,分别测试。识别结果与原页逐项比较,先检查整体层级,再核对字母、负号和上下标。对含条件的长式子,读到末尾后再回查一次原页,避免裁切完整但识别结果漏掉右侧内容。
把差异记录和页码关联起来:哪些属于图像不清、哪些是形近字符、哪些是结构丢失。修正一条后,试着再次改变一个变量,确认得到的是可编辑表达。文件材料很多时,可按页或章节处理并标注完成状态,不把一次成功的小样解释为所有页都能无误转换。
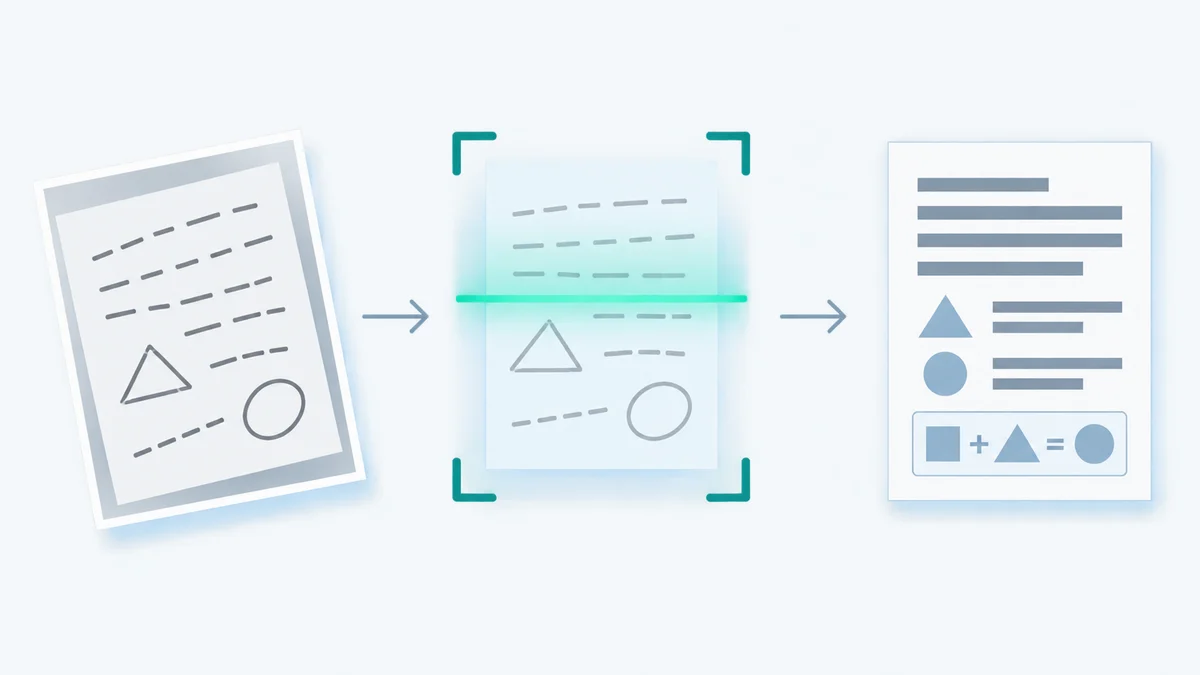
在本站走已支持的图片入口
本站帮助中心说明的图片识别接受 PNG、JPG、BMP,单张不超过 5MB,需要登录加会员。处理 PDF 材料时,可先在阅读器中取得清晰的公式截图,再按图片入口提交;不能把这条路径写成本站直接接收整份 PDF 或自动识别全部页面。
识别后的内容进入公式编辑器,可用预览模式观察结果,或切到 LaTeX 模式修改源码。确认结构后插入文档,登录保存;需要带走成果时按目标格式输出并检查,导出须回到预览模式。源 PDF、裁切图和修正后的式子应保留对应信息,这样发现疑问时仍能定位原页,而不是仅剩无法追溯的一段文字。
延伸阅读
- Mathpix 替代:把材料提取与后续写作分开比较。
- 公式识别后怎么编辑:按层级、字符与交付顺序回改。
常见问题
- PDF公式识别工具为什么要先看文本层?
- 文本层能提供提取线索,扫描页则通常需要图像处理。但可以选中文字不代表公式结构完整,复制结果仍需与页面上的原式核对。
- 扫描版 PDF 的公式怎样准备识别?
- 先确定页码和公式位置,按清晰比例查看并裁出完整公式,保留上下限和末尾条件,再将图片按识别入口要求提交并人工校对。